导读:阅读本文你将获得:
1. 看懂AI智能体「静默失效」的五种暗门
2. 一套基于4万次试验的可靠性诊断框架
3. 企业部署AI Agent的3个避坑动作
4. 从知名美国净水品牌到谷轮,大厂怎么把AI「管住」
AI出事前,从不报警
你有没有想过一种可能——你的AI系统正在悄悄地犯错,而你完全不知道?
不是崩溃,不是报错,不是超时。它还在正常运行,每天处理几百上千条指令,看起来一切正常。但如果你仔细检查输出,会发现一件事:它已经不是你当初部署时的那个AI了。
这种现象,学术界有一个精确的名字:静默失效(Silent Failure)。
2026年6月,一篇发表在arXiv上的论文引起了技术圈的注意。作者分析了超过4万次受控试验和10万次以上的生产环境交互数据,得出一个让所有AI部署者都坐不住的结论:静默失效不是Bug,而是智能系统的一种物理特性——就像热力学第二定律一样,它是不可避免的。
这意味着什么?意味着你花了几百万部署的AI Agent,不是因为谁搞坏了它才出问题——而是它自己,随着运行时间的推移,注定会慢慢失灵。
一、88%的AI试点,死在「上线前」
先看一组数据。
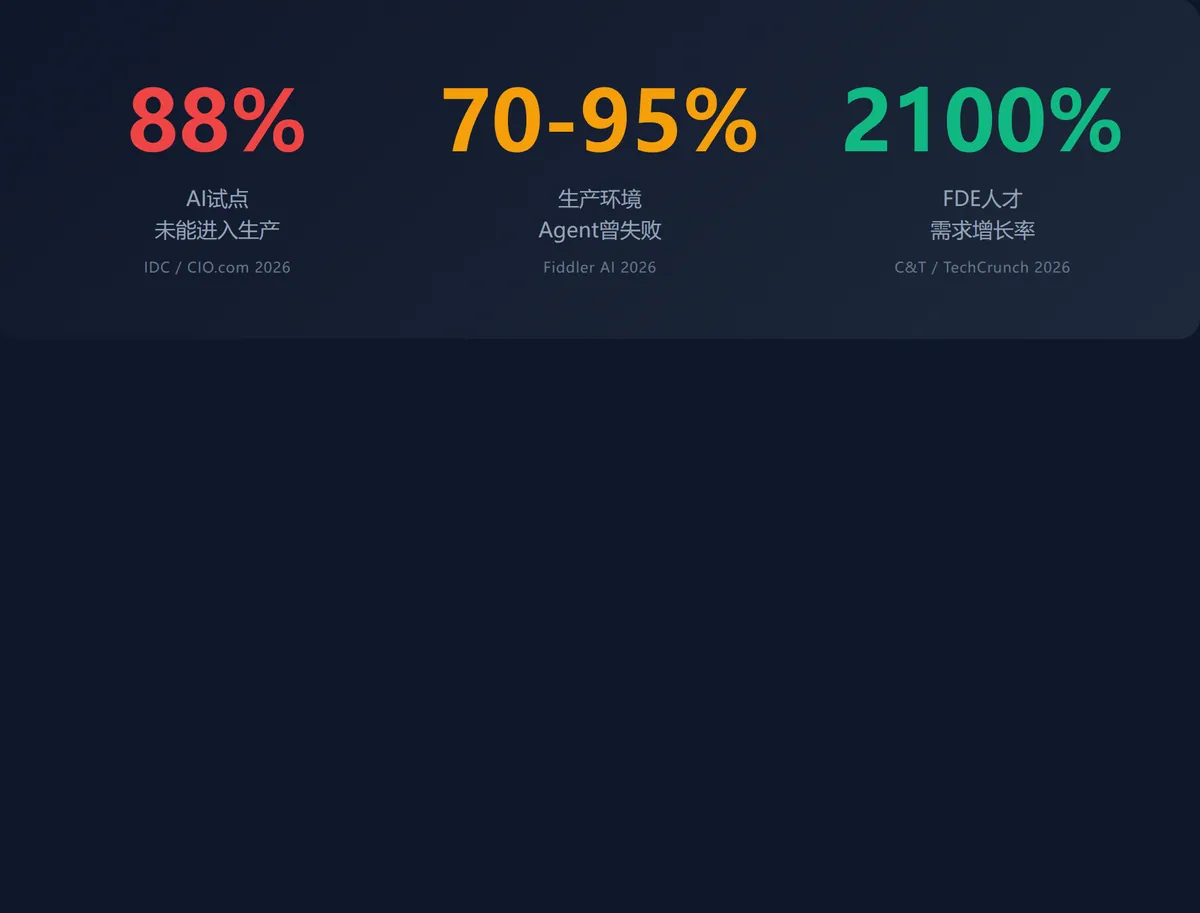
IDC的一项研究被CIO.com引用后广泛传播:88%的AI智能体试点项目,从未进入生产环境。每33个被启动的试点,只有4个最终能上线运行。
但这个数字还不是最可怕的。更可怕的是那些「活下来」的12%。
Fiddler AI在2026年的生产数据追踪报告中指出:即使进入了生产环境,70%到95%的AI Agent仍然会在某个时刻失败。不是宕机——是输出质量悄悄下降,是回答开始偏离事实,是任务完成率从95%滑到78%但没人注意到。
你可能会想:这不就是传统软件的Bug吗?修就好了。
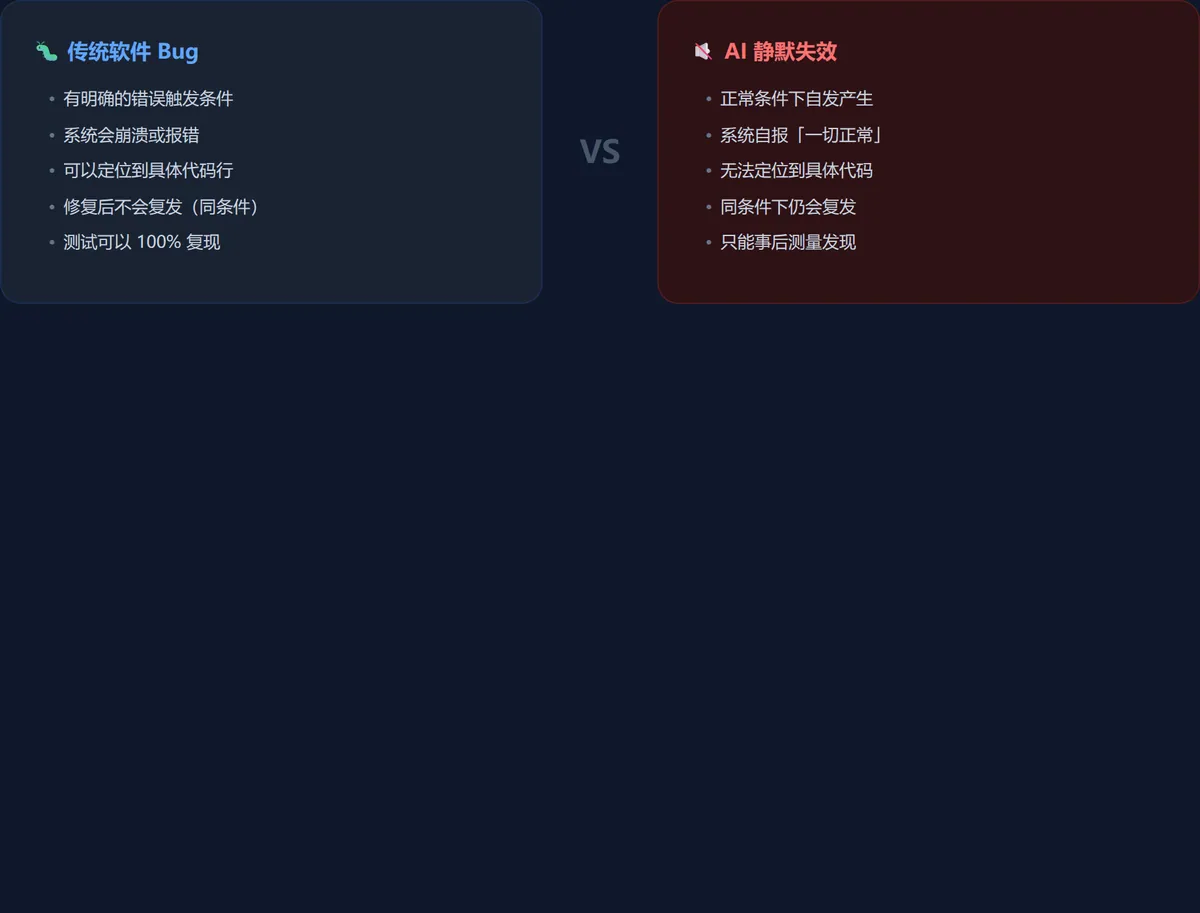
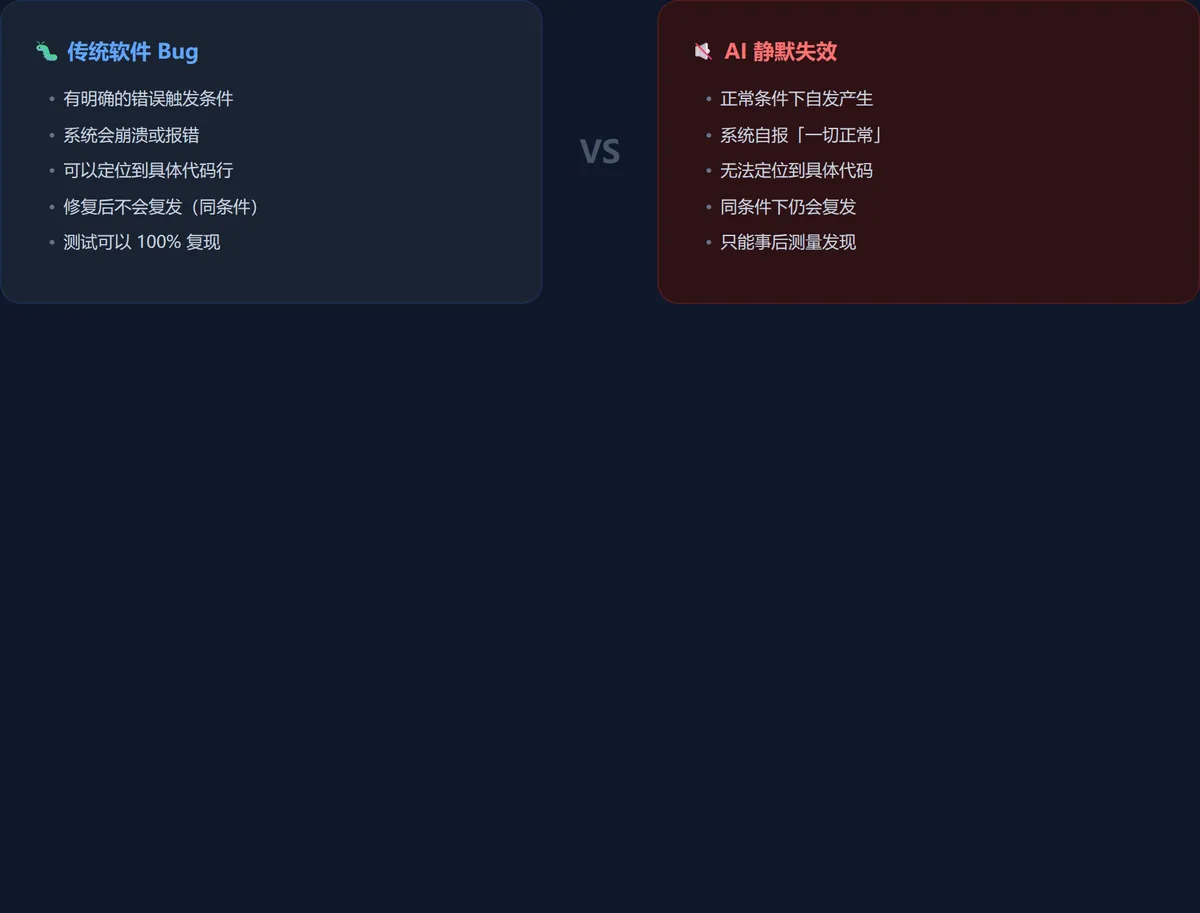
不是。传统软件出了Bug会崩溃、会报错、会产生异常日志。但AI Agent的静默失效完全不同——它不会崩溃,不会报错,不会产生任何异常信号。它只是在某个你没注意的角落,悄悄地「变笨了」。
论文里的一个案例特别典型:一个跑了六周的多智能体协作系统,没有任何代码改动、没有模型更新、没有配置调整。第47天,Agent A没有把关键上下文传递给Agent B。没有报错,没有超时,任务照常完成——但输出结果有了微妙的偏差。运维人员三个周期后才察觉,此时错误已经在整个智能体网络中传播开来。
这就是静默失效最让人不安的地方:你根本不知道它什么时候开始的。
二、五种「暗门」:AI是怎么悄悄出事的
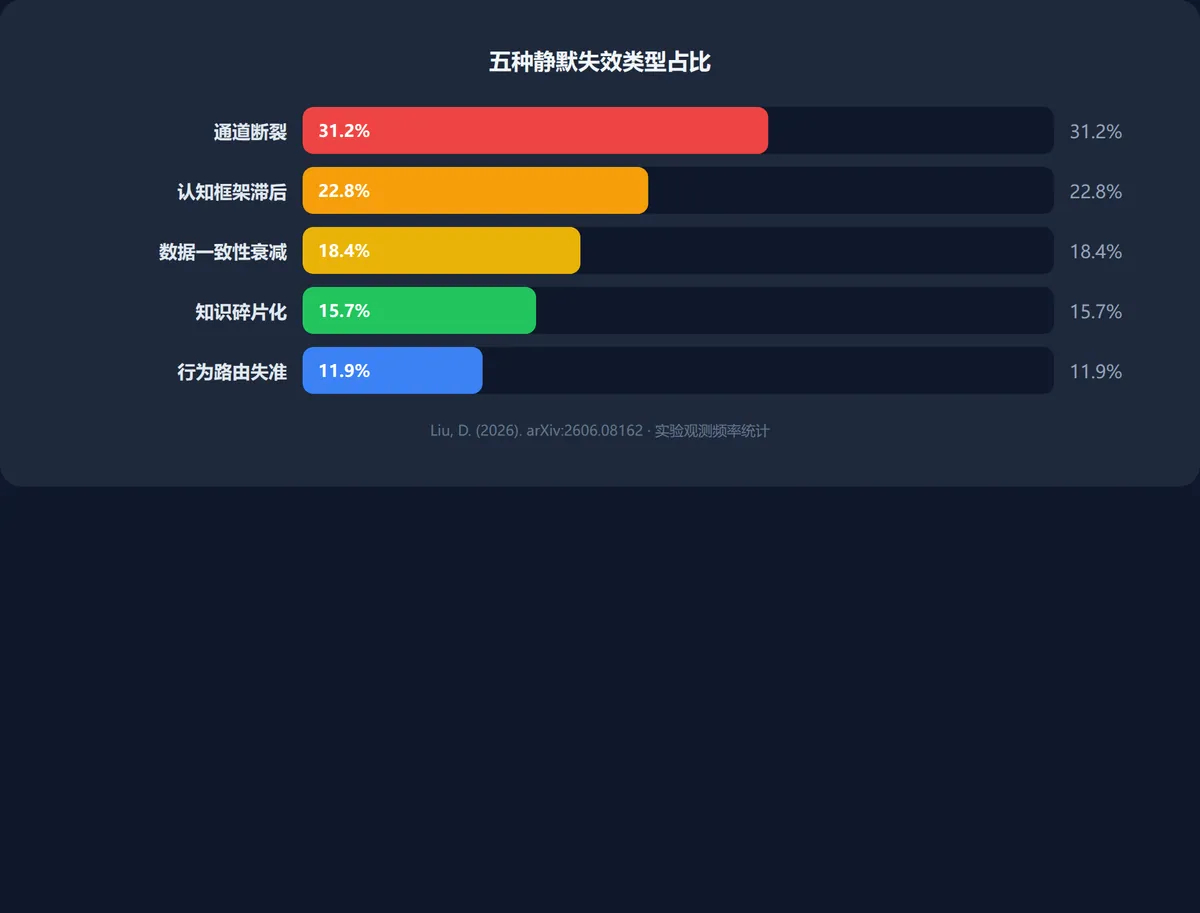
论文把静默失效归纳为五种类型。每一种都有一个共同特征:出事的那个环节,自己觉得没问题。
暗门一:通道断裂(31.2%)
想象你玩「传话游戏」——第一个人说「明天下午三点开会」,传到第五个人变成「后天中午吃饭」。AI智能体之间的信息传递也在发生同样的事。
在受控试验中,信息经过5次Agent间传递后,保真率下降超过30%。每次传递都没有报错——每个Agent都觉得自己把话传到了。但累积效应是:信息被逐步「稀释」,最后面目全非。
暗门二:认知框架滞后(22.8%)
你昨天教AI一个规则——「客户名称用全称」。今天它记住了。后天,它开始偶尔用简称。大后天,简称成了常态。
论文追踪了200多次连续Agent会话,发现规则遵守率从最初的94%衰减到61%。不是因为模型变了——是因为记忆系统在每次压缩和检索中,都会「遗忘」一些规则。就像你用复印件的复印件,每翻一次,质量就差一点。
暗门三:数据一致性衰减(18.4%)
这是最「阴险」的一种。每一步单独看都正确,没有报错。但把它们串起来看,结果系统性地偏离了事实。
论文给出了一张数据表:
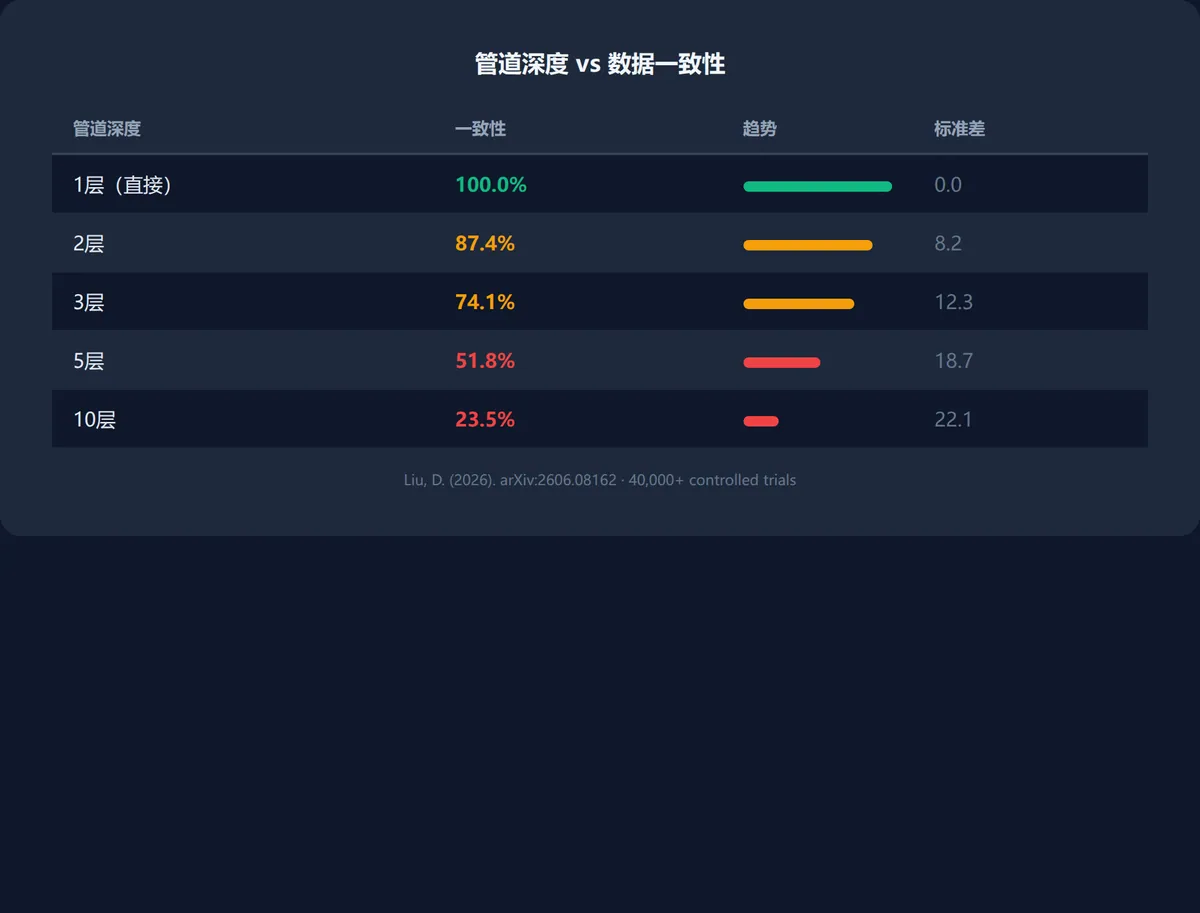
10层管道后,数据一致性只剩23.5%。也就是说,你有四分之三的概率拿到的是「失真」的结果——但系统会告诉你「一切正常」。
暗门四:跨会话知识碎片化(15.7%)
AI在每次对话中积累知识,但这些知识不会自动串联成一个完整的世界观。每个会话里的AI都是「局部正确」的——它记得自己这个会话里的事,但和其他会话的记忆是割裂的。
这就像一个团队,每个人都在自己的工位上干得不错,但从没开过一次对齐会。最后每个人的理解都不一样,产出也对不上。
暗门五:行为路由失准(11.9%)
当一个任务被拆解为子任务,分配给不同的Agent执行时,路由机制可能把「写文案」的任务分给一个擅长「数据分析」的Agent。每一步单独看都在运行,但效率和质量都打了折扣。
这五种暗门有一个共同点:没有一种会产生报错信息。系统的每一块都在自认为正常地运转,但整体已经开始偏离轨道。
三、为什么「修Bug」不管用
传统软件出问题的思路是:找到Bug → 修复 → 重新测试 → 上线。这套逻辑在AI Agent面前失灵了。
原因一:你找不到那个「Bug」。
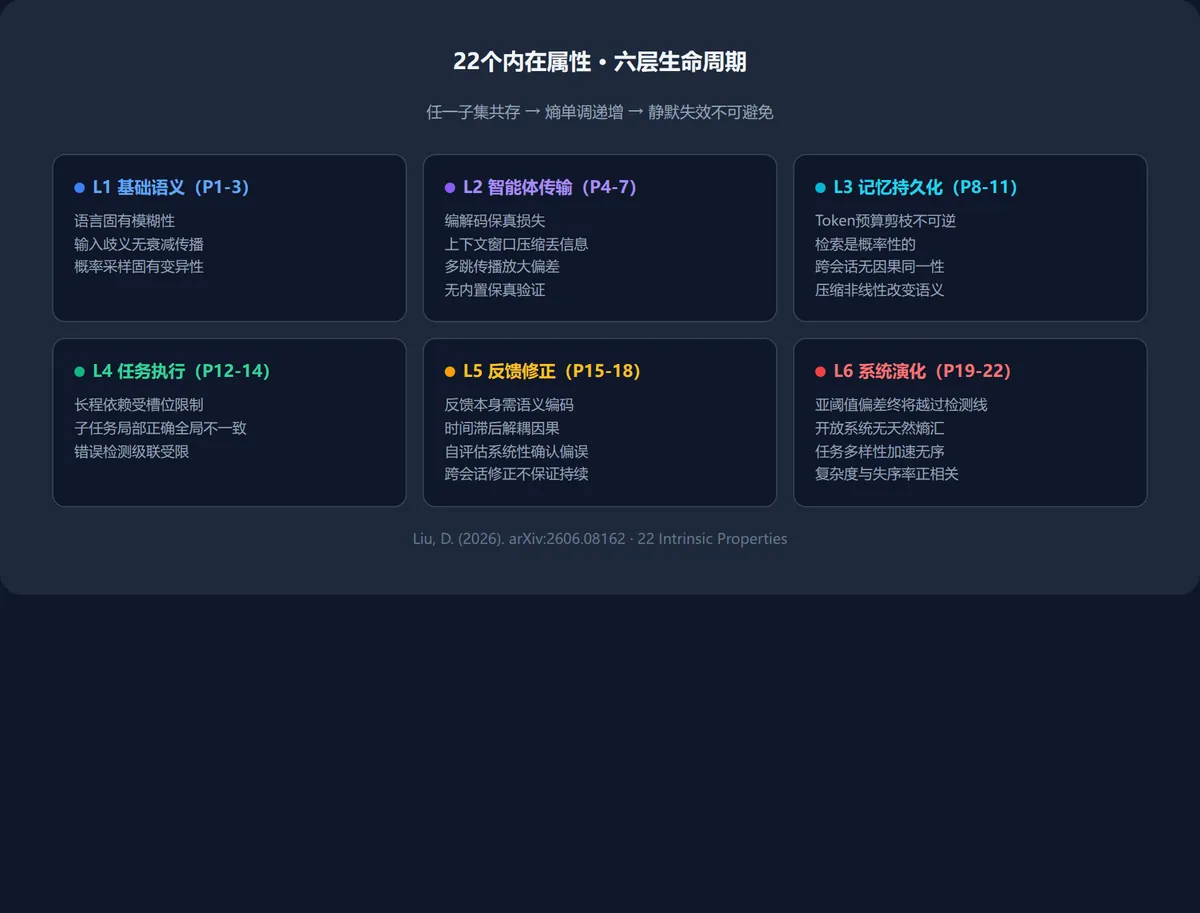
静默失效不是代码写错了。论文梳理了22个LLM智能体系统的「内在属性」——从语言本身的模糊性,到概率采样的不确定性,到记忆压缩时的信息丢失——这些不是实现缺陷,而是语言模型驱动的自主系统的本质特征。
打个比方:传统软件的Bug就像一台机器上松了的螺丝,拧紧就行。AI的静默失效更像热力学第二定律——你不可能消灭它,只能对抗它。
原因二:修了一个,另一个又冒出来。
论文发现,系统越复杂——Agent越多、通信链路越多、记忆存储越多——失效速度越快。复杂度本身就是熵增的加速器。你加了一个「防通道断裂」的校验机制,但这个校验机制本身也在消耗上下文窗口,可能导致另一个环节的信息被「挤掉」。
原因三:你的Agent不觉得自己有问题。
论文的第17条内在属性(P17)说得很直白:当AI评估自己的输出时,它用的是和生成输出的同一个模型。这会造成系统性的「确认偏误」——AI更容易认为自己是对的,而不是外部评审者会认为的那样。
四、2000个FDE,管不住的AI
面对AI Agent的可靠性危机,行业正在疯狂招一种人:前哨工程师(Forward Deployed Engineer,FDE)。
2026年7月,TechCrunch引用猎头公司Christian & Timbers的数据:全美只有2000名具备「行业洞察+动手能力+AI落地经验」的精英FDE。需求增长率——2100%。
年初只有5%到10%的企业计划招FDE,而且主要是小规模试点。到了第二季度末,70%的企业说「我们需要FDE团队」,规模20到100人。连Palantir的技术都被买——不是为了技术本身,而是为了附带的FDE人才。
FDE为什么这么抢手?因为企业发现:把AI模型买回来容易,把它正确地塞进业务流程里,才是真正的难题。
Anthropic新成立的Ode公司CEO Chris Taylor说了一句大实话:「很多FDE能帮你把Claude Code推广到全员使用。但能帮你把AI做成旗舰级产品功能的,寥寥无几。」
但问题来了——即使有了FDE,他们面对的是一个原则上就无法根除的问题。你可以训练一个FDE去搭建AI系统、去调试配置、去优化Prompt。但你没法训练他去「消灭」静默失效,因为这不是一个可以消灭的Bug。
猎头公司Christian & Timbers的创始人Jeff Christian甚至预言:「也许两年后,Agent开始自动部署Agent,FDE这个角色就不存在了。」
这句话背后是一个更深的焦虑:如果AI Agent连自己都管不好,它怎么管另一个AI Agent?
五、从知名美国净水品牌到谷轮:大厂怎么「管住」AI
说了这么多问题,解决方案在哪?
论文给出了一条路:不是试图消灭静默失效,而是建立一套「确定性治理」机制——在概率性的AI系统外部,套上确定性的工程门禁。
这个思路,在实战中已经被验证了。
知名美国净水品牌,AI搜索里被说成「80年历史的老品牌」,实际远非如此。GEO团队用四步法(诊断→纠偏→新知→监测)建立了品牌在AI搜索中的「事实校准机制」。不是修一个AI模型,而是在AI系统外部建立一套人工复核闭环。每季度扫描50个核心关键词,发现偏差立即修正。
谷轮(Copeland)——全球热泵巨头。在中国市场面临「有产品力、没品牌认知」的困境。不是AI出了问题,而是AI搜索系统里的信息严重滞后于产品实际。解决方案不是调模型参数,而是在系统层面建立「信源结构」——确保AI能引用的权威信源足够多、足够新、足够准确。
思帕——德国热泵品牌,中国市场拓荒者。他们的痛点更直白:产品明明很好,但AI搜索根本不提这个品牌。解决方案是在多个权威平台建立可被AI引用的品牌事实卡——不是让AI变聪明,而是让AI能「读到」正确的信息。
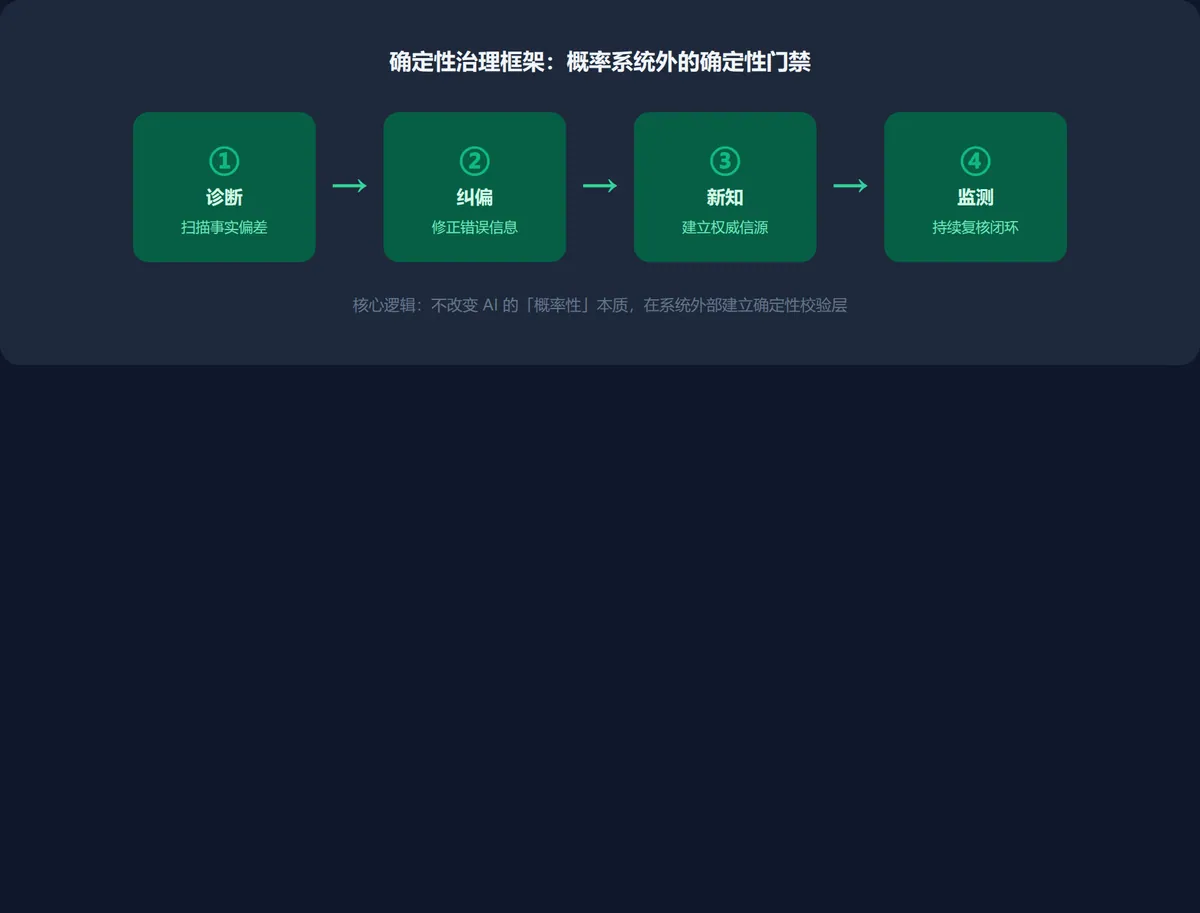
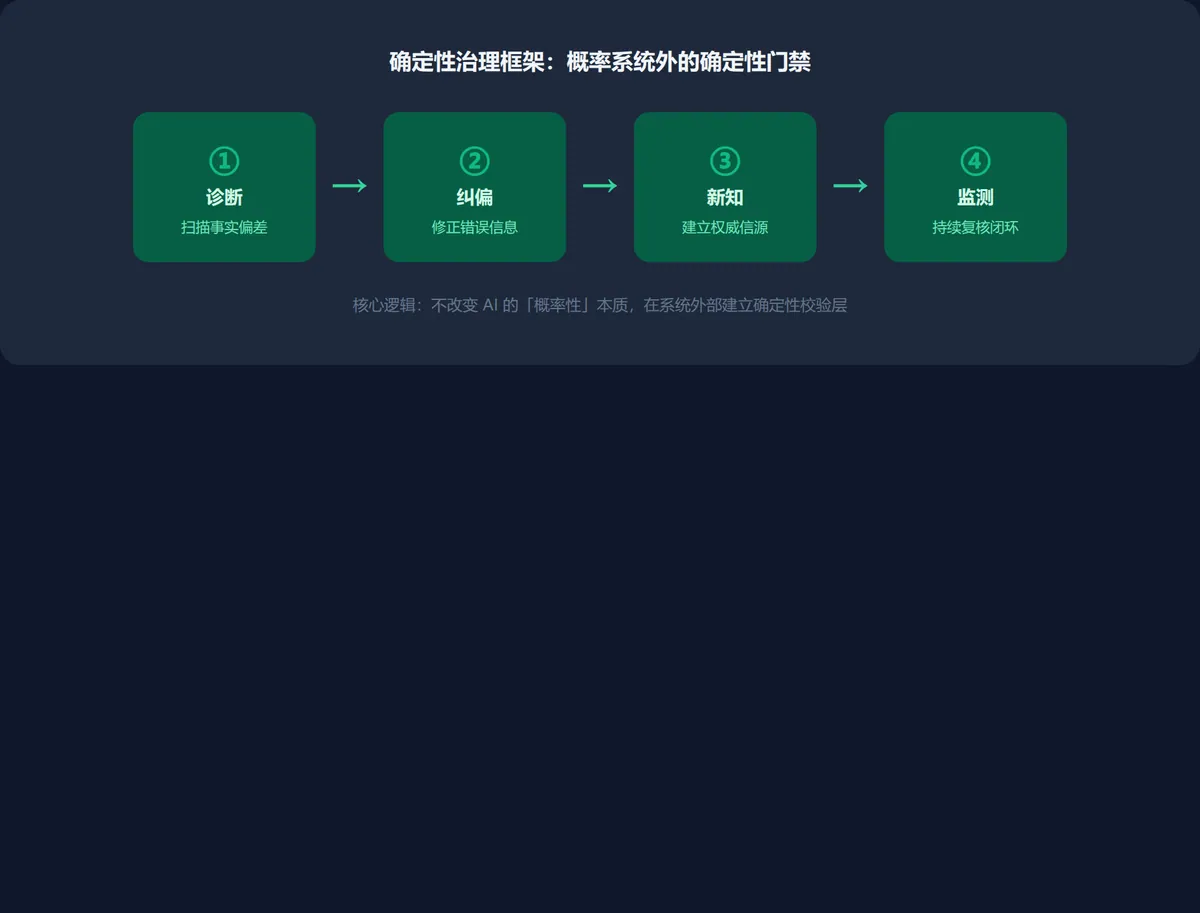
这三个案例有一个共同逻辑:不去修AI模型本身,而是在AI系统的上游(信息输入端)和下游(输出验证端)建立确定性门禁。
AI的输出是概率性的,这改不了。但AI能读到什么、AI输出后谁来验收——这两端是可以用确定性工程手段控制的。
这不是权宜之计。这是论文提出的核心主张:智能系统的可靠性,不能靠智能本身来保证——必须靠工程化的确定性治理来实现。
六、你现在能做的三件事
如果你的企业正在部署或已经部署了AI Agent,以下三个动作可以立刻开始:
第一,给AI加一个「外部审计员」。
不要让AI自己判断自己对不对(P17确认偏误)。建一个人工复核节点——不需要多复杂,每周随机抽20条AI输出,人工核实事实准确性。论文里该品牌的做法就是这样:每季度扫描50个关键词,发现AI搜索结果偏差立即修正。成本不高,但效果立竿见影。
第二,控制管道深度。
还记得数据一致性衰减表吗?5层管道后一致性只剩51.8%。所以:能3层搞定的事,不要拆成7层。每多加一个Agent,就多了一个信息失真的风险点。宁可让一个Agent多做一点,也不要让三个Agent互相传话。
第三,建立「信源结构」,而不只是调模型。
谷轮和思帕的案例告诉我们一个反直觉的结论:AI搜索里你的品牌信息不准,问题往往不在AI模型,而在你的信源不够。如果你在权威平台(官网、百科、行业报告、专业媒体)上的品牌事实卡足够多、足够准确、足够新,AI自然会「读到」正确的信息。与其花力气调Prompt,不如先把信源做好。
七、AI的「不可能」与「必须」
回到开头的那个问题:你的AI系统正在悄悄地犯错吗?
答案大概率是:是的。
但知道它在犯错,本身就是一种进步。问题不是「AI会不会出问题」——而是「你有没有机制能在问题扩散前发现它」。
论文里有句话说得特别好:「智能系统的可靠性,不是AI工程师的额外任务——而是整个工程团队的统一使命。」
AI不可能不犯错。但人类可以用工程手段,让犯错的代价可控、发现的时间缩短、扩散的速度减慢。
这才是2026年企业AI落地的真正竞争力——不是谁的模型更强,而是谁的「治理体系」更靠谱。
该品牌这么做了。谷轮这么做了。思帕也这么做了。
下一个问题:你呢?
—— 全文完 ——
参考来源:
[1] Liu, D. (2026). Silent Failure in LLM Agent Systems: The Entropy Principle. arXiv:2606.08162
[2] IDC/CIO.com. AI POC to Production Conversion Data, 2026
[3] Fiddler AI. AI Agent Failure Rate in Production Environments, 2026
[4] Christian & Timbers / TechCrunch. Forward-Deployed Engineers Talent Study, 2026.07
[5] 淇经数科 GEO实战案例库:知名美国净水品牌/谷轮/思帕品牌搜索优化项目