AI闭嘴,反而更好用?
导读:阅读本文你将获得:
- 看懂最近爆火的「哑巴模型」Jev 到底是什么
- 算清一笔账:一次 AI 判断,成本只要万分之一美元
- 明白为什么它先在微信场景火起来
- 拿走一套「高把握自动、低把握转人工」的分流思路
- 看清它的两条硬边界,别急着把它捧上天
微信群里最难回的消息,不是刁钻的问题,而是那句「你看着办」。
回还是不回?现在回还是晚上回?@不@对方?要不要转人工?这些问题没有标准答案,但每一件都在消耗一个真人的判断力。最近爆火的一个 AI 模型,专治这种事——它有个外号,叫「哑巴模型」。
01 只会做选择题的 AI
这个模型叫 Jev,9 月 16 日由旧金山公司 TypeSafe AI 发布。创始人是 GPT-4 论文共同作者、前 OpenAI 研究员迪奥戈·阿尔梅达(Diogo Almeida),公司隐身研发两年,出来时带着 DCVC 领投的 4000 万美元种子轮。
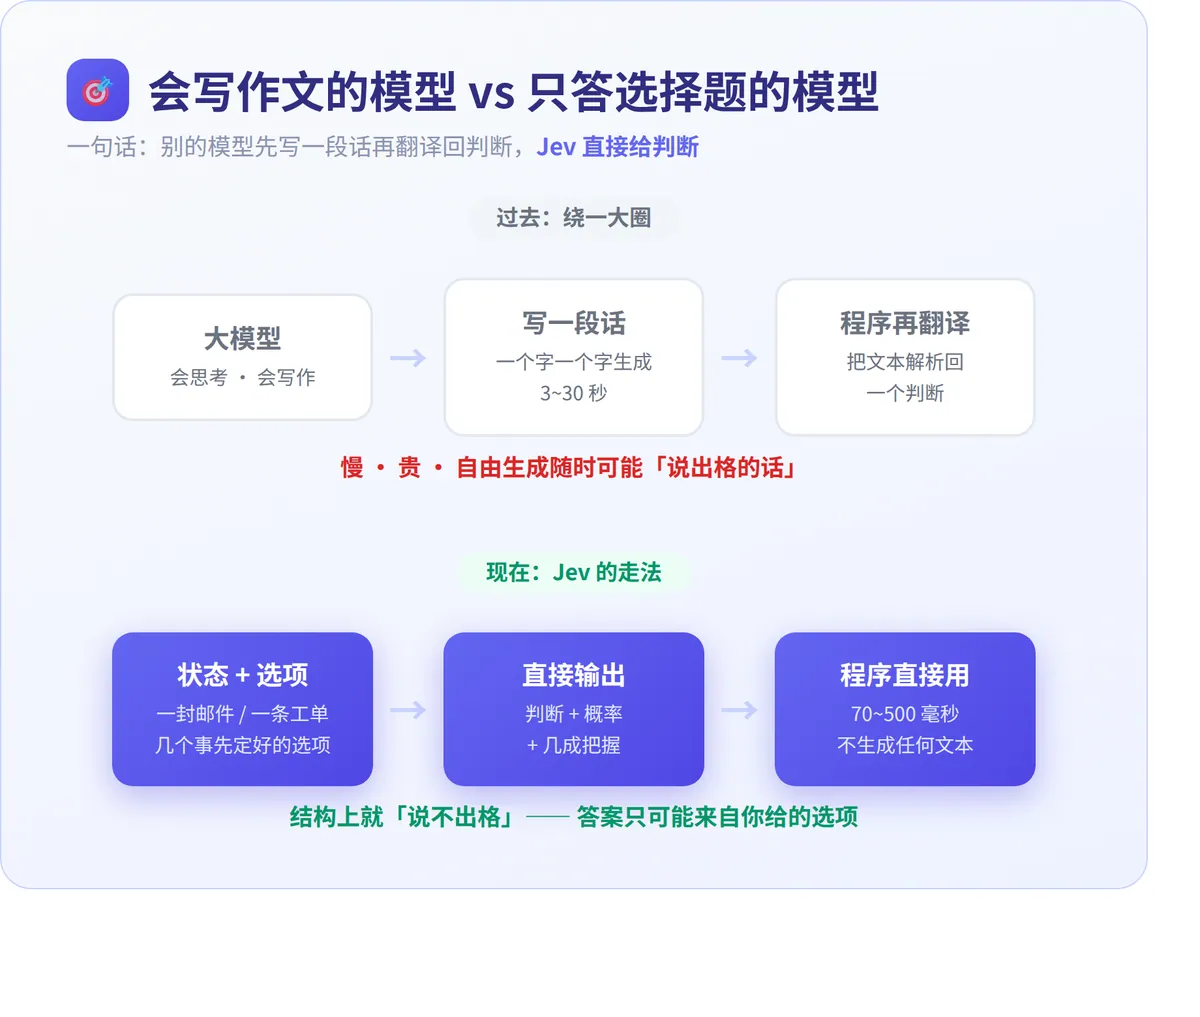
Jev 的标签叫「系统一模型」(System One Model),名字来自卡尼曼的《思考,快与慢》:系统一是不过脑子的直觉判断,系统二是慢下来一步步推理。这家公司的判断是:这几年所有人都在造系统二——会思考、会写长文、会解释;可软件里真正需要的判断,大多数是系统一。
数据来源见图内标注 · 部分配图由AI生成
所以 Jev 和 ChatGPT、Claude 走的不是一条路:别的模型会写作文,Jev 只会答选择题。你给它一段状态——一封邮件、一行日志、一条工单,再给它几个事先定好的选项,它一次性把答案全返回,每个答案附一个概率,外加一个「我有几成把握」的置信度。
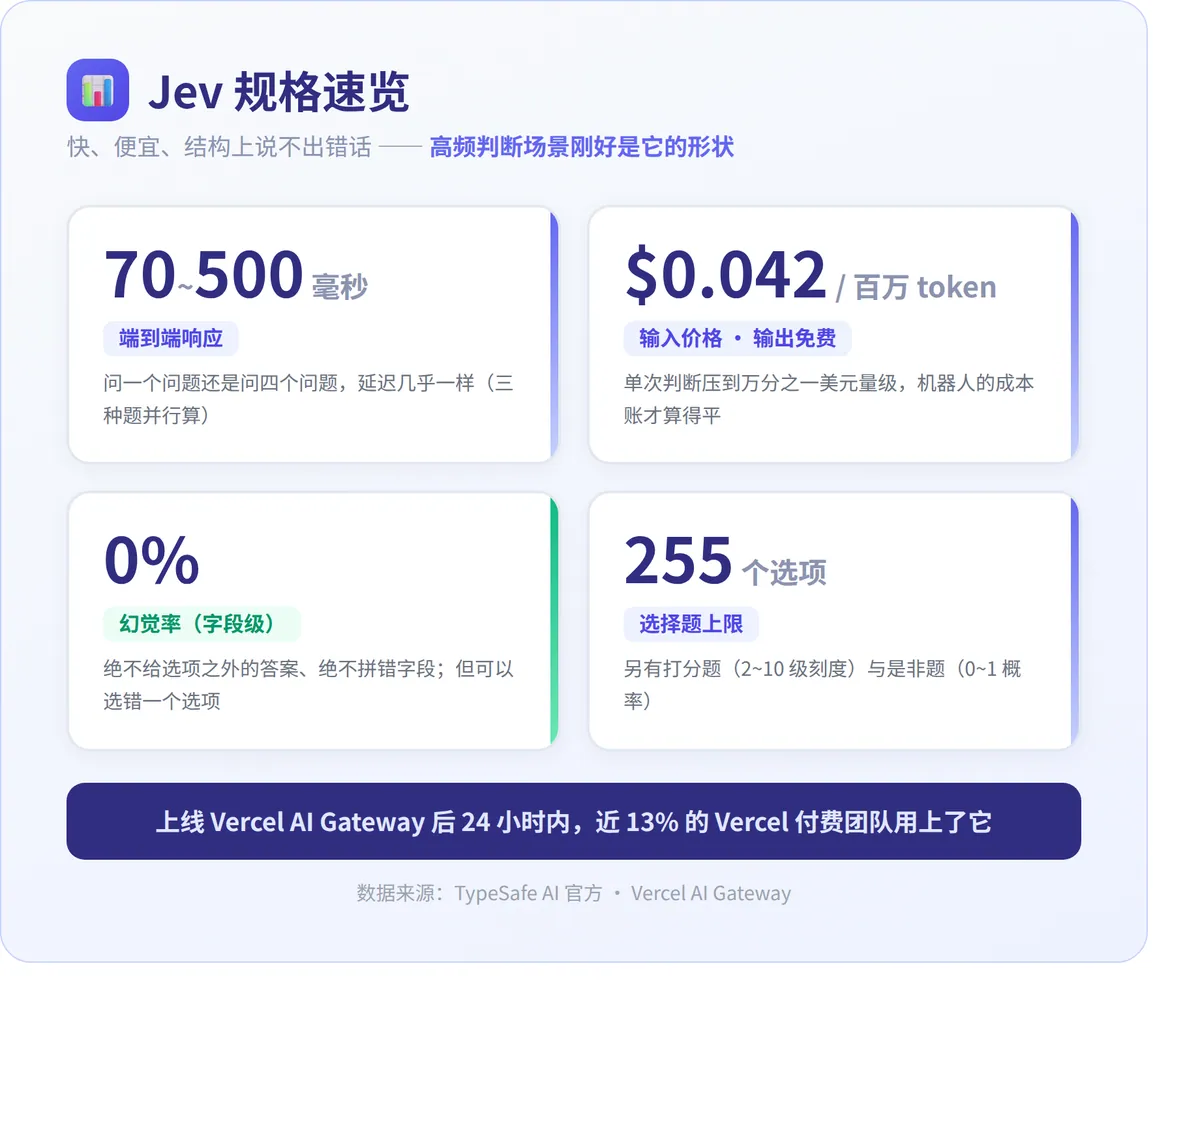
它只会三种题:选择题,从最多 255 个选项里选一个;打分题,在 2 到 10 级的刻度上给分;是非题,给出一个 0 到 1 的概率。三种题可以混在同一个请求里并行算,官方说问一个问题还是问四个问题,延迟几乎一样。
02 一次判断,万分之一美元
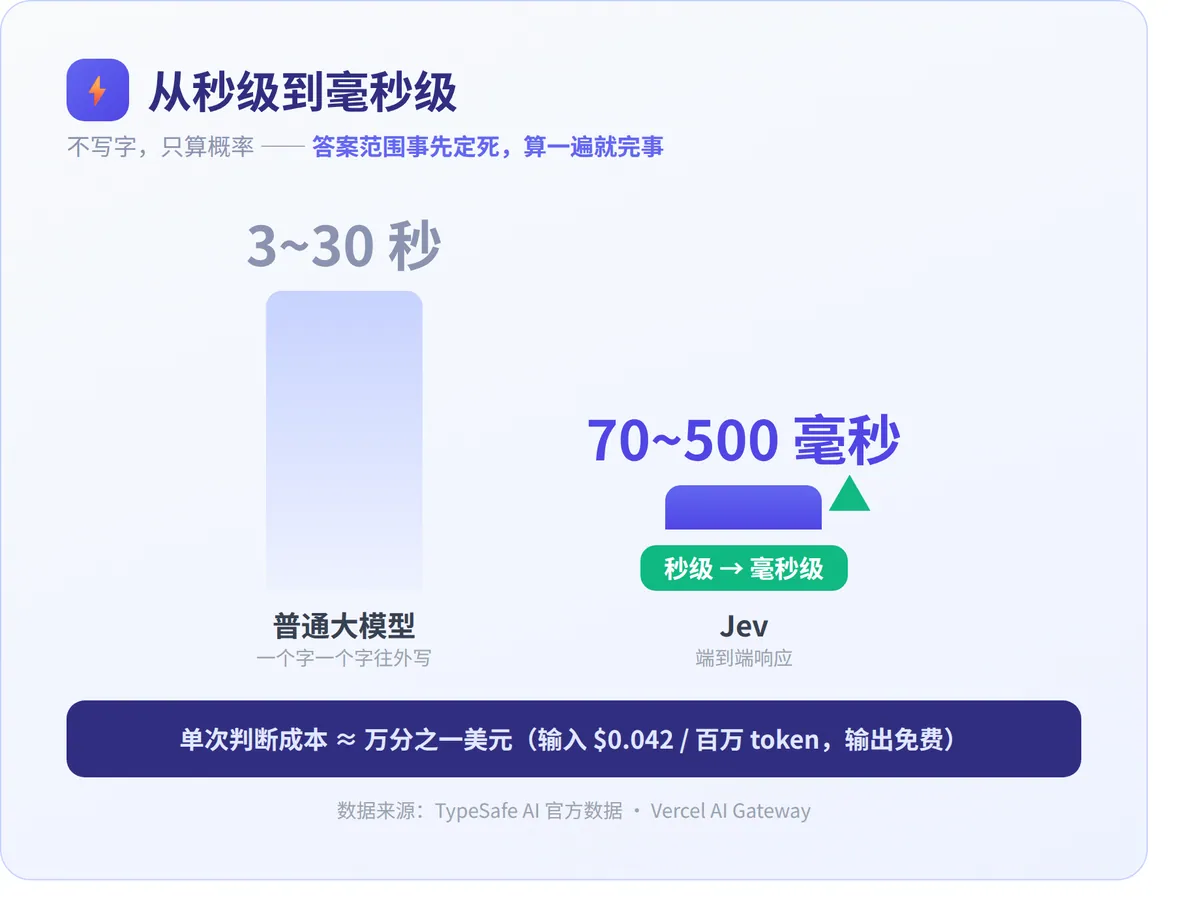
Jev 的特点是快和便宜。普通大模型是一个字一个字往外写,写多久取决于要写多长;Jev 不写字,答案的范围事先就定死了,算一遍每个选项的概率就完事。
数据来源见图内标注 · 部分配图由AI生成
按官方数字:端到端响应 70 到 500 毫秒,输入每百万 token 0.042 美元,输出免费。折算下来,一次判断的成本压到了万分之一美元的量级。它上线 Vercel 的 AI Gateway 后,24 小时内近 13% 的 Vercel 付费团队都用上了,是 Vercel 平台采用速度最快的新模型。
它还有个罕见指标:幻觉率为 0%。指的是它绝不会给出选项之外的答案、绝不会拼错字段。但要说明白——它可以选错一个选项,这一点连 CEO 自己也承认。
数据来源见图内标注 · 部分配图由AI生成
03 为什么它先在微信爆火
Jev 发布没几天,社区拿它用得最多的地方,是微信。
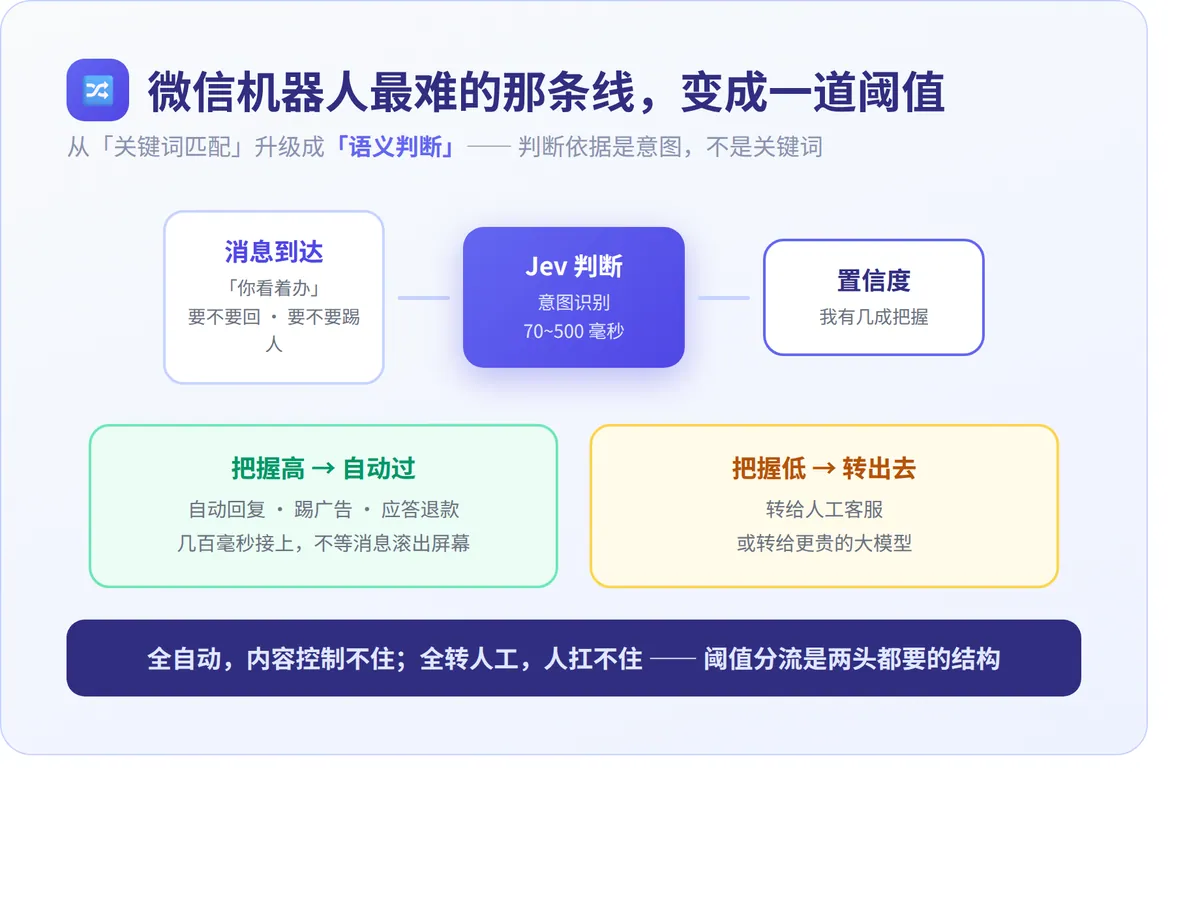
微信最难的不是收发消息,是精准判断对方的意思。经典场景「你看着办」:是让你小改一下,还是放着不管,还是大刀阔斧?这条消息要不要回?要不要@对方?这是不是广告?要不要把人踢出群?要不要转人工?这个人是不是想退款?
每一件,都是「从有限选项里挑一个」,而且要在几百毫秒内出结果。这正好是 Jev 的形状。
数据来源见图内标注 · 部分配图由AI生成
那为什么不用大模型?三个原因。
第一,慢。大模型回一条要 3 到 30 秒,群消息是滚动的,你回的时候对方可能已经不耐烦了。Jev 只要 70 到 500 毫秒,够你在消息滚出屏幕之前接上。
第二,贵。微信机器人通常跑在便宜的服务器上,一次判断的成本必须低到可以忽略。用大模型逐条判断,几十万条消息就是一笔真金白银;Jev 把单条判断压到万分之一美元的量级。
第三,也是微信插件最怕的:它说不出错话。一个自由生成的大模型塞进聊天框,随时可能冒出一句不该说的话,轻则社死,重则触发风控、直接封号。Jev 根本不生成文本,只从你给的选项里挑——从结构上就「说不出格」。
微信插件的老大难,是「自动回复」和「转人工」之间那条线:全自动,内容控制不住;全转人工,人扛不住。Jev 给每个判断配一个校准过的置信度,这条线就变成了一道阈值——把握高就自动过,把握低就转给人,或者转给更贵的大模型。这套分流,本来就是微信客服和社群运营最想要的结构。
它还顺手升级了老玩法:以前机器人靠关键词匹配,命中关键词才回复,对方换个说法就失效。Jev 把「关键词匹配」升级成了「语义判断」——判断依据不是关键词,是意图。
04 判断层,正在变成基础设施
Jev 火得这么快,是因为它踩中了一个大问题:Agent 为什么还是又慢、又贵、又脆?
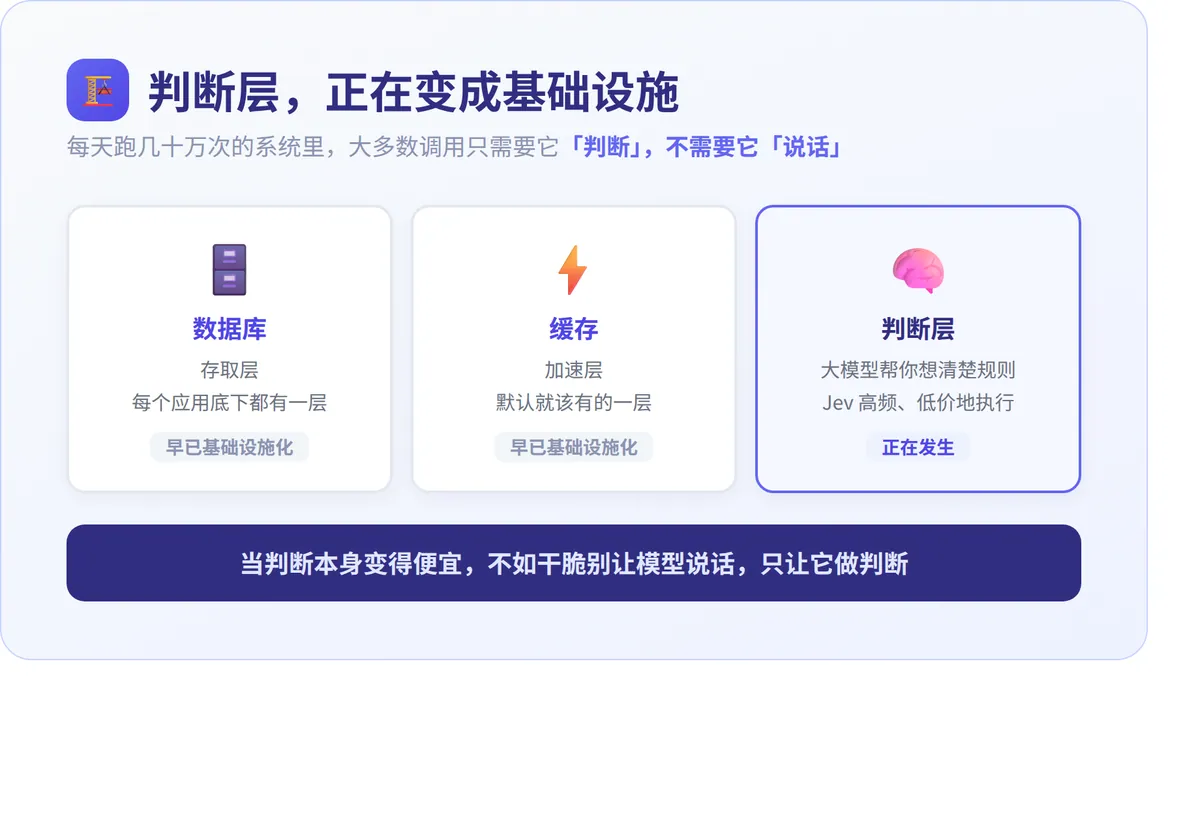
过去两年的 AI 叙事,是更长的上下文、更聪明的推理、更漂亮的回答。可当你真把一个模型塞进每天要跑几十万次的系统里,你会发现其中绝大多数调用,根本不需要它「说话」,只需要它「判断」:一条客服工单归哪个部门,一次工具调用有没有风险,一段 AI 的输出有没有跑偏。
数据来源见图内标注 · 部分配图由AI生成
这些问题从来都只有一个正确答案,而且选项早就写在自己的代码里。让一个会写作文的模型先写一段话,再由程序把它翻译回一个判断,绕了整整一大圈。Jev 想省掉的,就是这一圈。
我们在给 知名美国净水品牌 净水、谷轮、百世快运这些品牌做 AI 获客系统时,用的是同一套思路:客户咨询进来,高把握的常见问题自动应答,低把握的转人工,中间地带升级到大模型。真正的功夫不在「自动回复」这四个字上,而在那道阈值划在哪、校准得准不准。
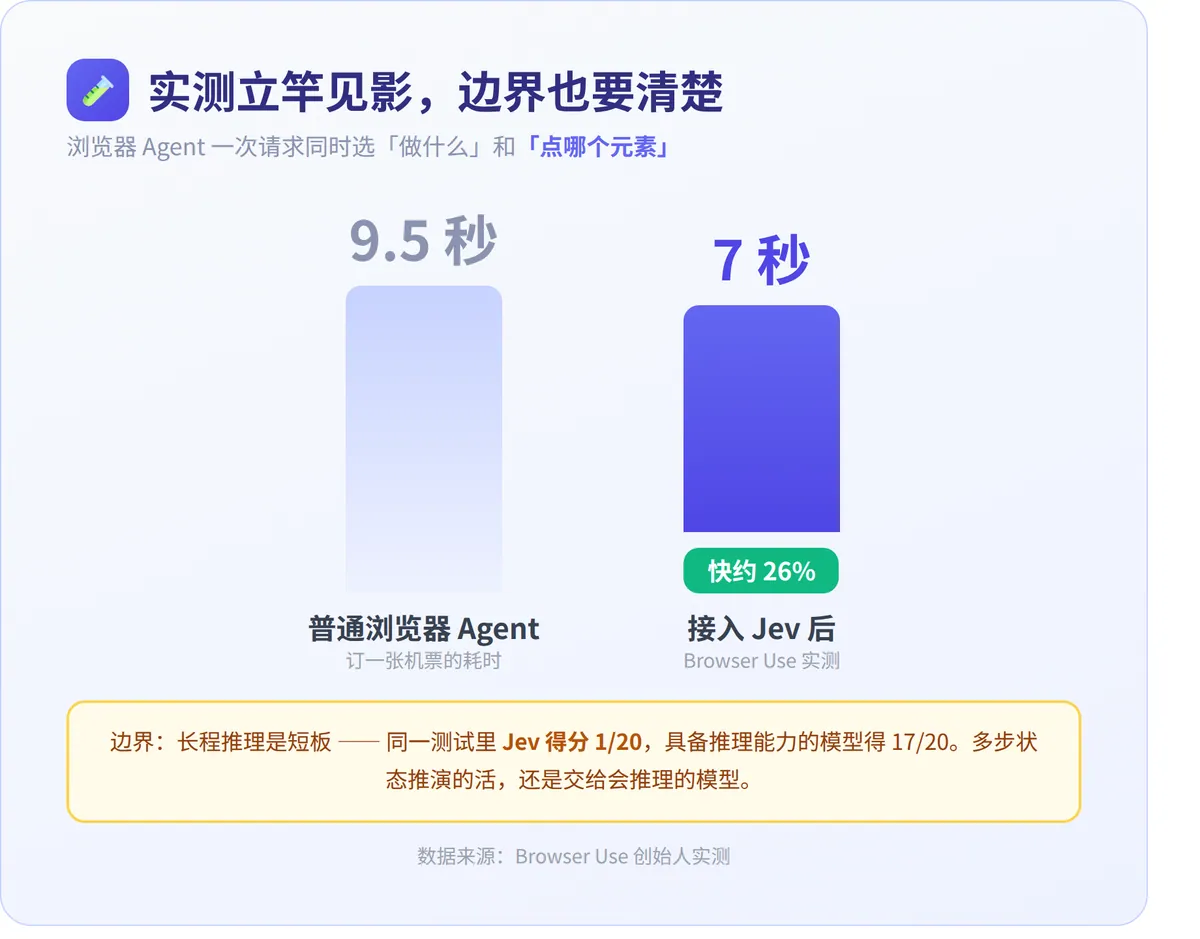
效果也是立竿见影的:社区实测,通过 Browser Use 把 Jev 用在浏览器 Agent 里,一次请求同时选「做什么」和「点哪个元素」,订一张机票的时间能从 9.5 秒缩到 7 秒。
有一个猜想值得记住:当判断这件事本身变得便宜,那不如干脆别让模型说话,只让它做判断。判断层会像数据库、像缓存一样,变成一层默认的基础设施,藏在每个应用的最底层。微信插件只是一个开始。
数据来源见图内标注 · 部分配图由AI生成
05 别急着捧:它有两条硬边界
先把丑话说在前面。
第一,中文不是它的主场。官方文档明确标注,Jev 对中日韩文本(CJK)的准确率偏低,英文短文本表现相对稳定。拿它处理中文消息流,先小流量验证,别直接全量上。
第二,它没有推理能力。Browser Use 创始人实测的长程浏览器交互里,Jev 最终成绩 1/20,落后于具备推理能力的 GPT-5.6 Luna 的 17/20。浏览器操作涉及状态空间搜索与路径回溯,Jev 不具备多步状态推演能力;面对真实网页里未清洗的 DOM、异步加载与突发弹窗,它缺乏应对能力。
所以「Jev 取代大模型」是个伪命题。正确的做法是:大模型帮你想清楚判断规则,Jev 在生产环境里高频、低价地执行。它真正值钱的地方在于校准——把看似模棱两可、没有标准答案的问题给量化,一眼便知道答案应该选什么。
判断越频繁、越琐碎、越怕错,它就越合适;反过来,需要创造力、需要多步推理的活,还是要交给会说话的模型。
把判断交给只做判断的 AI,把表达留给会表达的 AI——各干各的活,成本和靠谱程度反而都上去了。
你微信群里的机器人,还在用关键词匹配吗?评论区聊聊你见过的「翻车现场」。