导读:阅读本文你将获得:
- 看懂「单次成功率」为什么是幻觉
- 一套辨认「假成功」的三层检查法
- 一份 100 题基准的真实成绩单(含没达标那项)
- 三个可以直接写进验收单的问题
我们内部有个记忆检索系统。做拒答测试,第一轮 20 道题,全对。
团队高兴了大概十分钟。有人去翻原始分数,发现这 20 道题的置信分全挤在 0.271 到 0.282 之间——上下差不到 0.011。系统里根本没有「拒答判据」这套机制,它只是这一轮碰巧全蒙对了。
一份 100 分的成绩单,背后是一套没在工作机制。这件事后来成了我们评测流程的分水岭:不再问「答对了几道」,改问「它答错的时候,我们多久能知道」。
一、单次成功率是幻觉
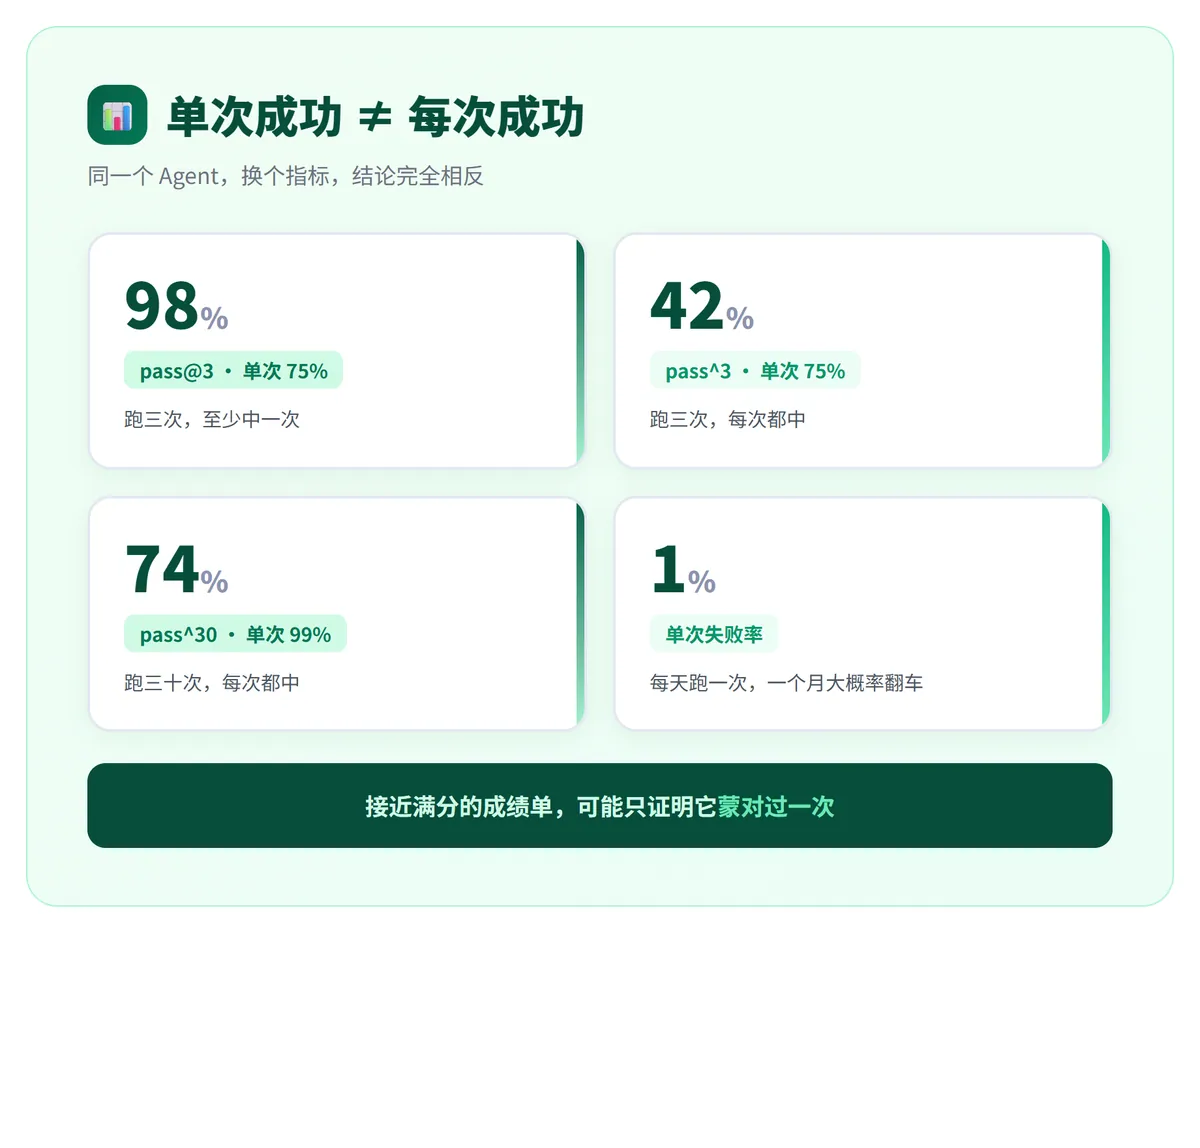
τ-bench 是专门测客服型 Agent 的评测基准,它提出了两个指标,只差一个字符,含义天壤之别:pass@k 和 pass^k。
pass@k 看的是「至少成功一次」,pass^k 看的是「每一次都成功」。
一个单次成功率 75% 的 Agent:跑三次,至少成功一次的概率是 98%;跑三次,三次全成功的概率是 42%。同一个 Agent,换个指标,从接近满分掉到不及格。
那如果单次成功率做到 99% 呢?连跑 30 次全成功,概率是 74%。也就是说,哪怕单次只有 1% 的失败率,你让它每天跑一次,一个月内大概率要翻车一次。
这就是演示场景和生产场景的分界线。演示只跑一次,生产每天跑一百次。
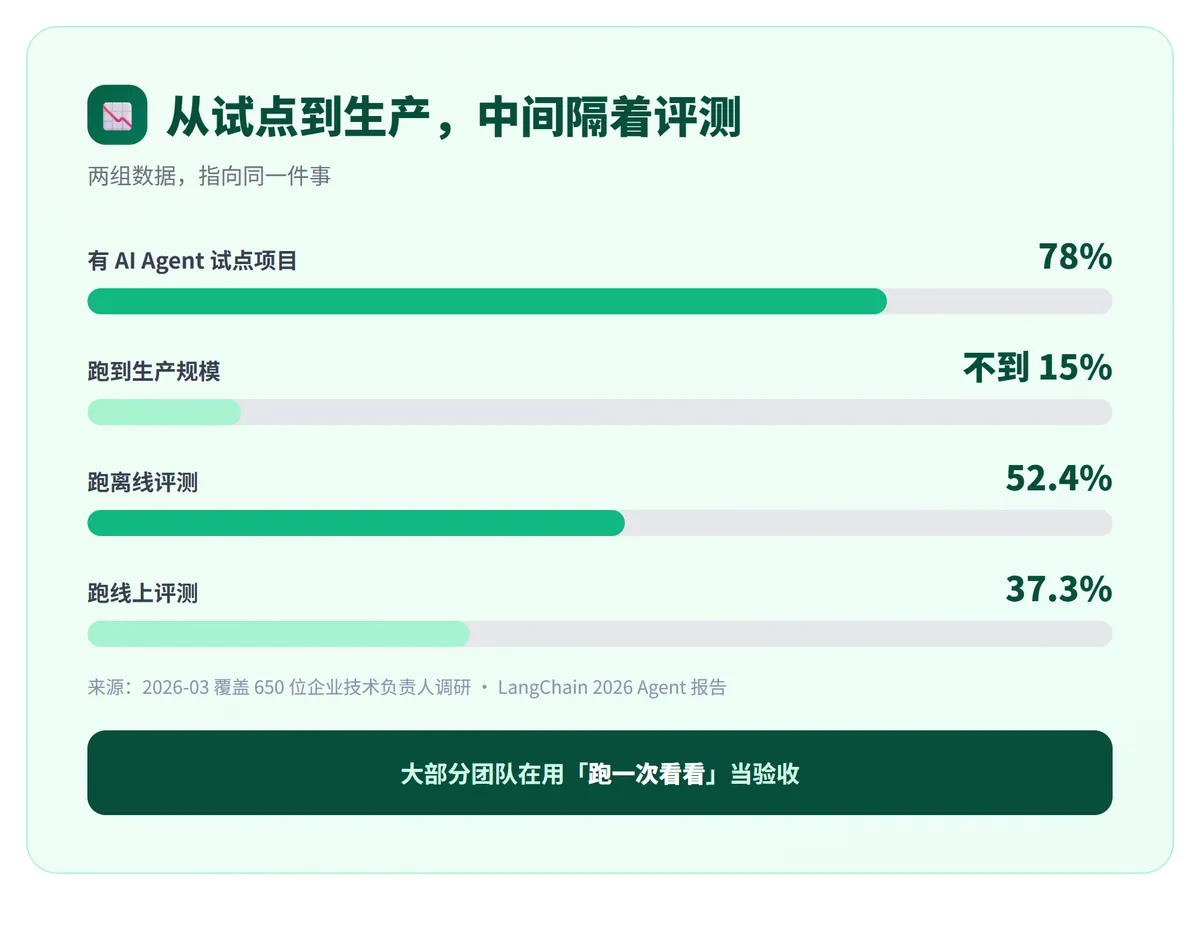
行业数据说的是同一件事。2026 年 3 月一份覆盖 650 位企业技术负责人的调研显示,78% 的企业有 AI Agent 试点,真正跑到生产规模的不到 15%。LangChain 2026 年的报告更直接:只有 52.4% 的团队在跑离线评测,37.3% 在跑线上评测。
翻译成大白话:大部分团队在用「跑一次看看」当验收。
二、蒙对有三种伪装
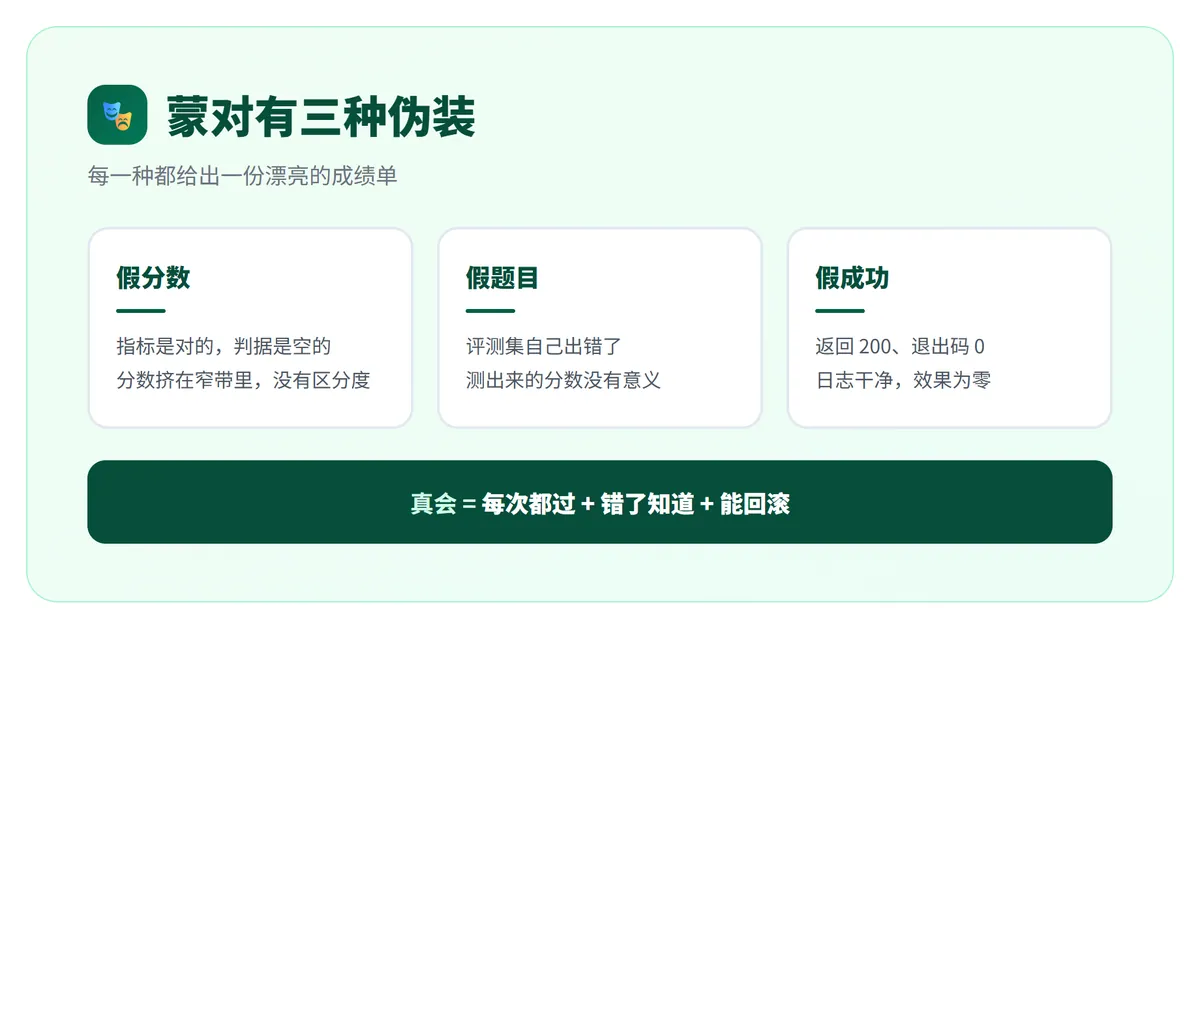
伪装一:假分数——指标是对的,判据是空的
回到开头那个 20/20。我们原来的拒答测试只看「系统有没有拒绝回答」,而这一轮所有题的置信分都挤在一个窄带里,谁的分数高谁的分数低没有区分度。测试通过了,机制没工作。
这种错误最贵。它不报错,还会给你一个漂亮数字,让你安心把系统推上生产。
伪装二:假题目——评测集自己出错了
设计「知识更新」题型时,想法很朴素:找出同一实体的新旧两条信息,看系统会不会用最新的那条。做法是拿「实体 + 时间跨度」做聚类。
结果在库里跑出 0 对真版本对。泛实体加时间跨度,聚出来的是「同一家公司在不同年份发生的两件事」,不是「同一件事的两个版本」。题目本身就错了,分数自然没有意义。
教训是:评测集也是代码,也需要被测。出题错了,比答题错了更隐蔽。
伪装三:假成功——静默失效
最危险的一种。接口返回 200,退出码 0,日志干干净净,实际效果为零。
我们在一篇论文里把这类故障命名为「通道断裂」(Channel Fracture),arXiv 编号 2606.04896。整理 52 个真实案例之后,抽象出 9 类可复现的根因模式:
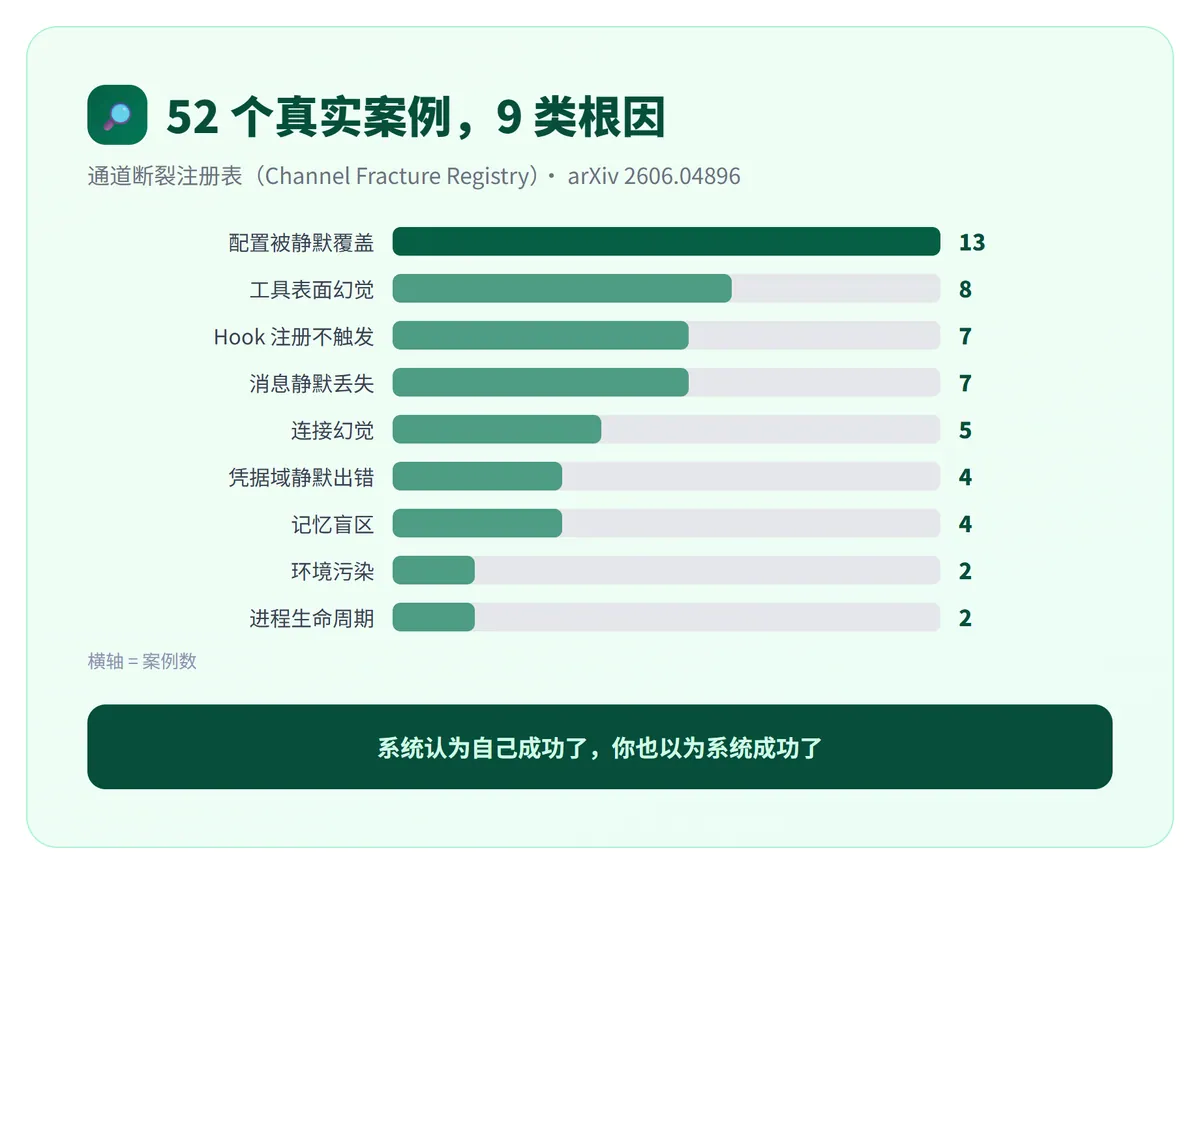
它们的共同点是:系统认为自己成功了,你也以为系统成功了。
举个我们实际踩过的例子。有一阵子,某个定时任务连续三天没有产出,但每天的巡检报告都是绿的——因为巡检只看进程在不在,不看任务有没有真的跑完。进程在,报告就绿;报告绿,就没人去看结果。
三、真会了,该怎么测
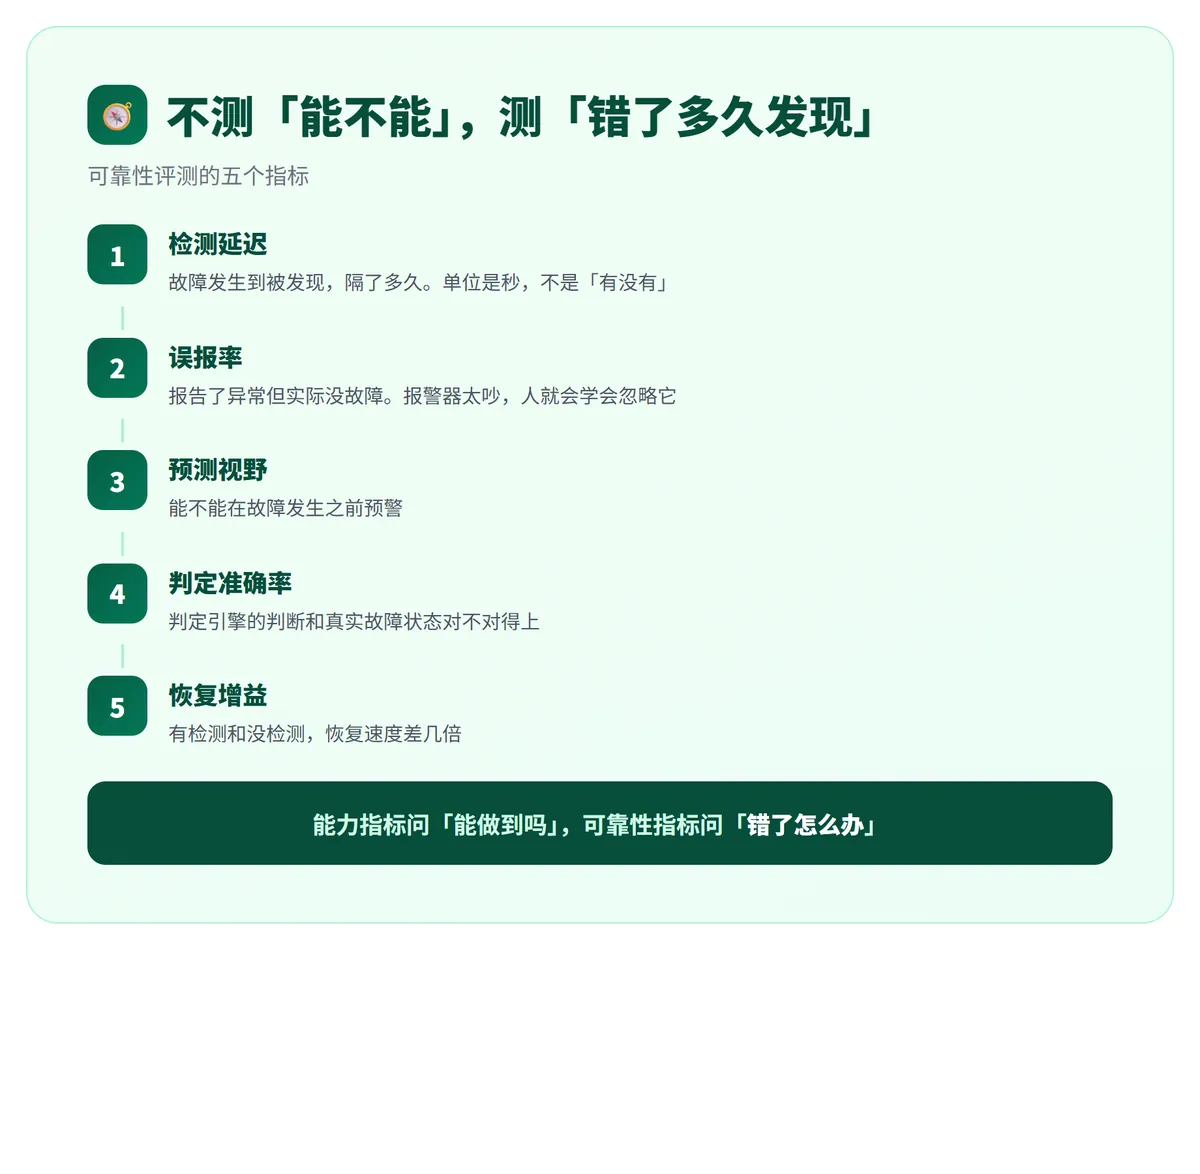
把「答对」换成「错了多久能发现」,评测的设计就完全不同了。我们用的是五个指标:
1. 检测延迟:从故障发生到被发现隔了多久,单位是秒,不是「有没有」。
2. 误报率:报告了异常但实际没故障的比例。报警器太吵,人就会学会忽略它,这是运维事故的常见起点。
3. 预测视野:能不能在故障发生之前预警。这是从「事后救火」到「事前干预」的分界线。
4. 判定准确率:判定引擎的判断和真实故障状态对不对得上。
5. 恢复增益:有检测系统和没有检测系统,恢复速度差几倍。
能力指标问「能做到吗」,可靠性指标问「错了怎么办」。前者决定上限,后者决定能不能上生产。
四、一张真实的成绩单
在某段严格管控的观测窗口内,我们对自己五个岗位共用的记忆检索层跑了一轮 100 题基准。题目按六类能力分布:信息抽取、多会话推理、时态推理、知识更新、拒答、组合推理。
同一套题,三轮结果:
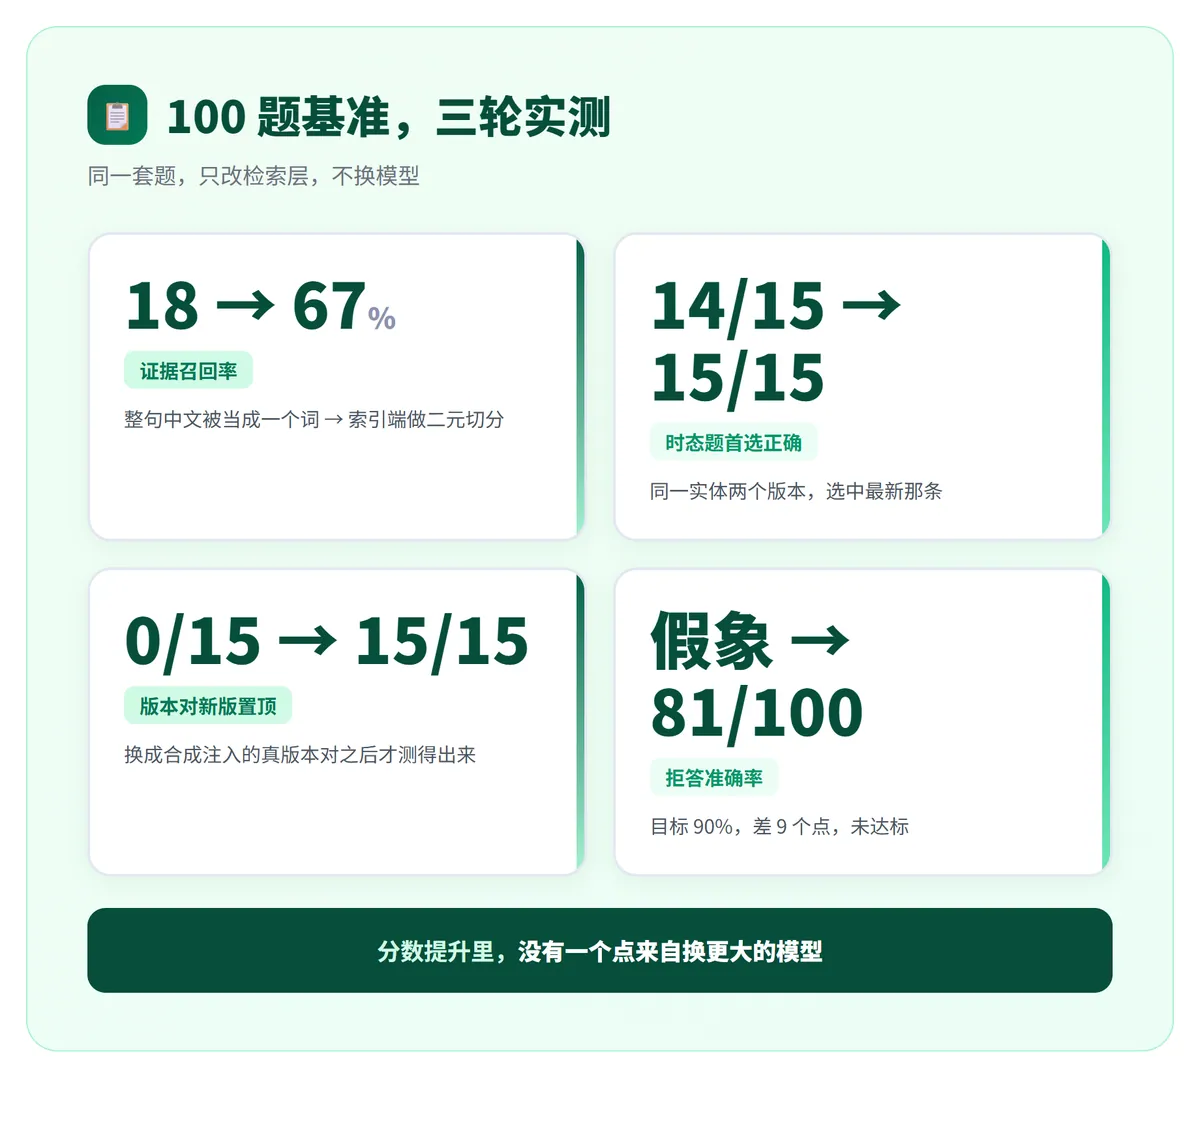
结论有两条。
第一,召回率从 18% 提到 67%,没有换模型。问题出在检索层——整句中文被当成一个词去匹配,候选集直接归零;改成索引端和查询端同步做中文二元切分,召回上到 67%。模型是同一个,成本几乎没变。
第二,拒答这一项没达标。目标线是 90%,实测 81/100,差 9 个点。这个数字我们如实写进了基线报告,也标了下一步的修法:给判据加一层「字段值存在性」检查——问卡号,就去看内容里有没有卡号形态,仍然零模型调用。
一份成绩单里最值钱的不是高分,是那句「这项没到」。它告诉你系统真实的边界在哪。
五、三个问题,写进验收单
如果你是技术负责人,或者要拍板买单的人,Agent 项目的验收单上建议加这三问:
1. 同一件事,它连续做 30 次,有几次会偏?问的是 pass^k,不是 pass@k。
2. 它做错了,你怎么知道?多久知道?问的是检测延迟,不是准确率。
3. 上一版和这一版,在同一套题上差多少?问的是回归,不是「感觉更好了」。
我们在给 知名美国净水品牌、谷轮、M77、百世集团这些客户做 AI 项目时,验收单的第一项从来不是准确率,而是「同一个问题在不同时间问五次,答案口径是否一致」。原因很简单:客户不关心你答对过多少次,客户关心下一次会不会翻车。
ADE 的核心原则只有一句:完成不是感觉,是验证。
回到开头那份 20/20。它教会我们的不是「要小心」,而是「要测准」——先确认尺子是准的,再谈成绩。
部分配图由AI生成